Доступ к облачным AI-сервисам зависит от внешнего провайдера, региона и правил конкретной платформы. Цель эксперимента — проверить возможность локального развёртывания модели, практически освоить архитектуру такой системы и создать основу для дальнейшего масштабирования в контролируемом или корпоративном контуре.
Основная ценность: собственная локальная модель снижает зависимость от доступности внешнего провайдера. При полностью локальном workflow содержимое запросов не требуется передавать стороннему облачному AI-сервису — это важно для чувствительных данных и NDA. Это не отменяет необходимости отдельно настроить безопасность сети, доступы и логи.
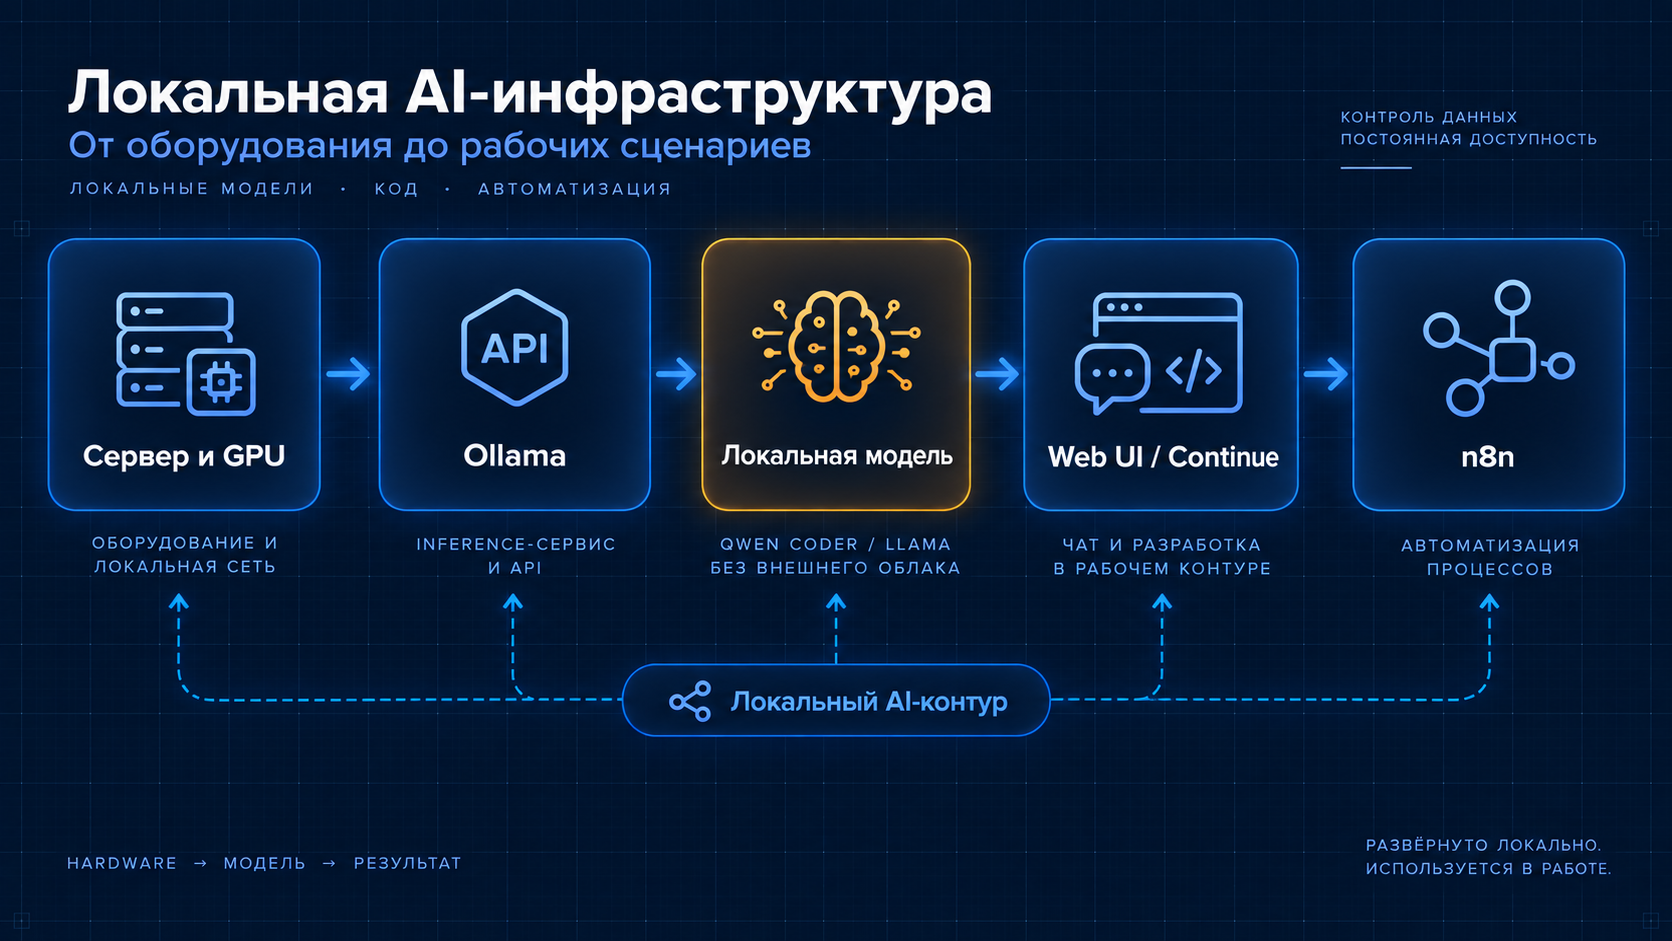
От оборудования до рабочих сценариев: сервер и GPU → Ollama → локальная модель → Web UI/Continue → n8n
Серверная материнская плата, два процессора Intel Xeon X5660 по 6 ядер / 12 потоков и Nvidia GeForce GTX 1660 Super с 6 ГБ VRAM. Ограниченные ресурсы сделали выбор размера и квантизации модели частью практической задачи.
Протестированы модели семейства Qwen Coder и Llama 3.2 в Q4-квантизации. В рабочем состоянии — Qwen Coder 2.5 7B и Llama 3.2.
- Вариант A — Ubuntu-сервер: отдельный выделенный сервер, доступ из домашней сети, локальный n8n для экспериментов с автоматизацией.
- Вариант B — Windows + WSL: Linux-окружение внутри Windows через WSL, Docker, Ollama и Web UI на localhost.
Оба варианта проверены на рабочих сценариях. Самостоятельная реализация — инфраструктура собрана и настроена с помощью консультаций AI-ассистента DeepSeek.
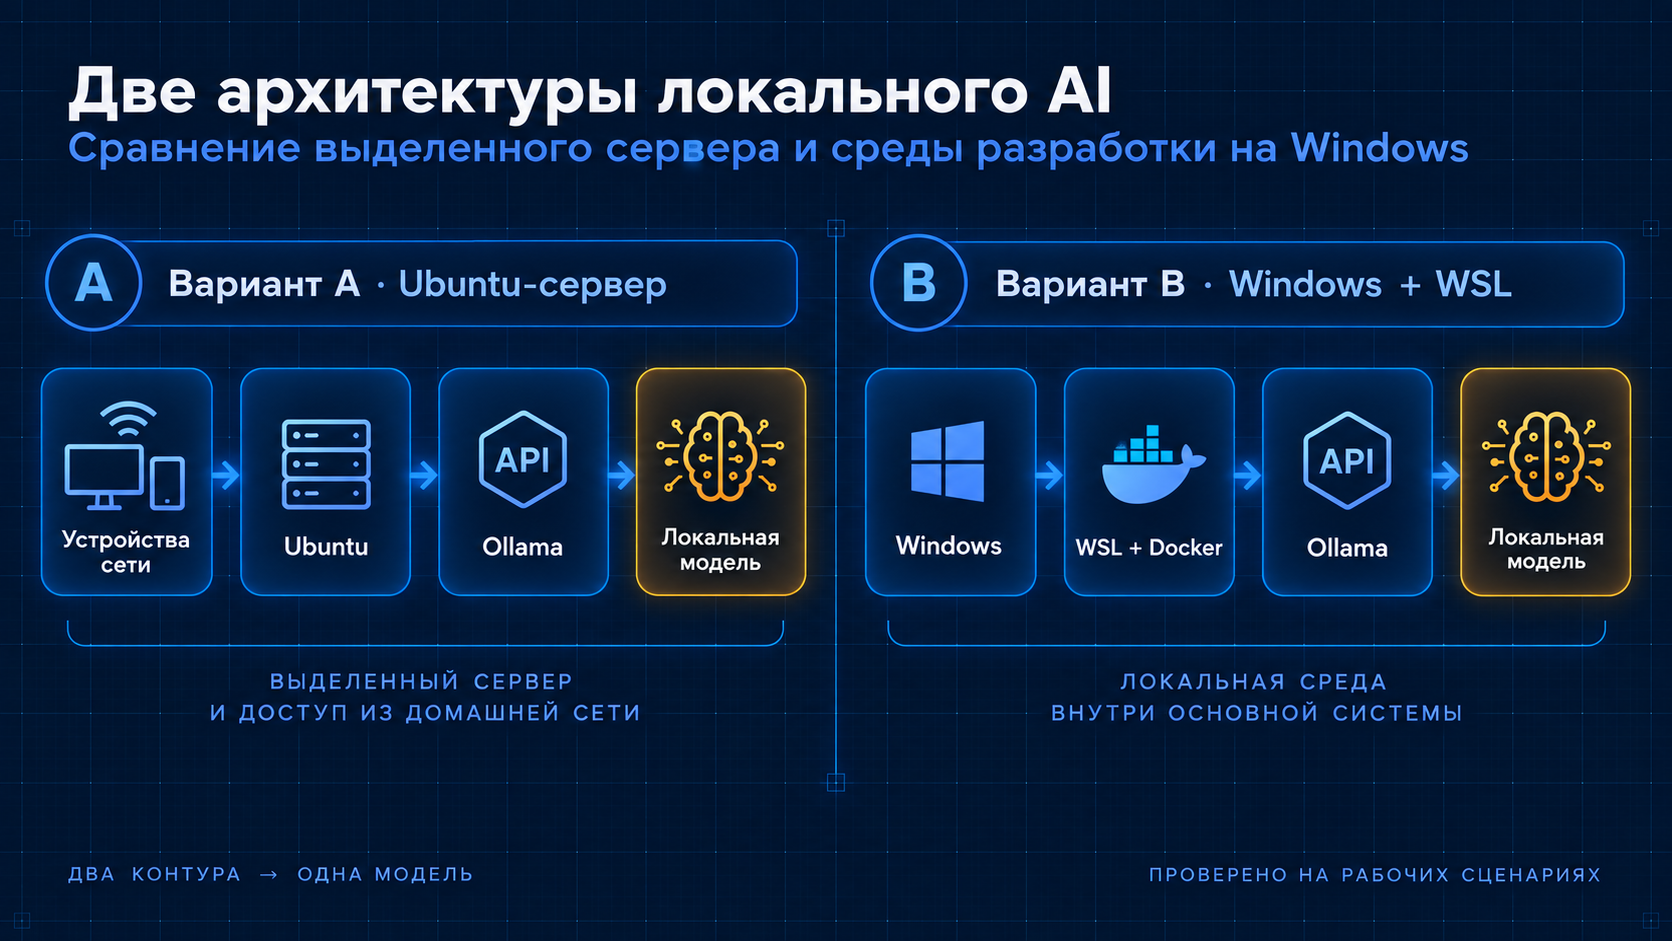
Сравнение выделенного сервера и среды разработки на Windows
- Диалог — через Web UI.
- Помощь с кодом — из VS Code через Continue.
- Автоматизация — обращение из отдельной ноды n8n к Ollama для обработки данных. Реальные примеры — агрегатор вакансий и дизайн-дайджест.
- Получен практический опыт развёртывания локального AI, подключения его к рабочим инструментам и автоматизированным процессам.
- Архитектура допускает переход к более крупным моделям при усилении hardware.
- Локальная модель используется не для демонстрационного чата, а как функциональная часть автоматизированных пайплайнов — см. кейс «Автоматизация в n8n».